百捷简历

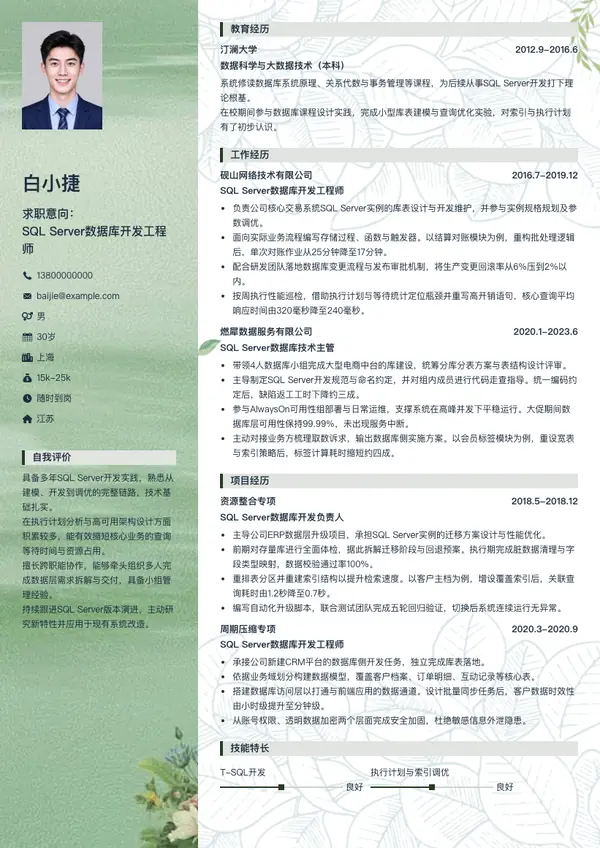
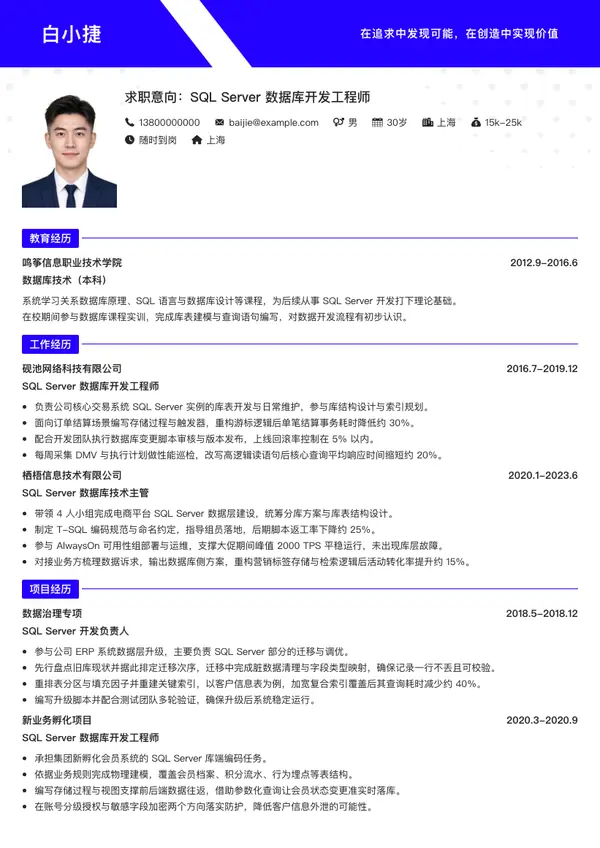
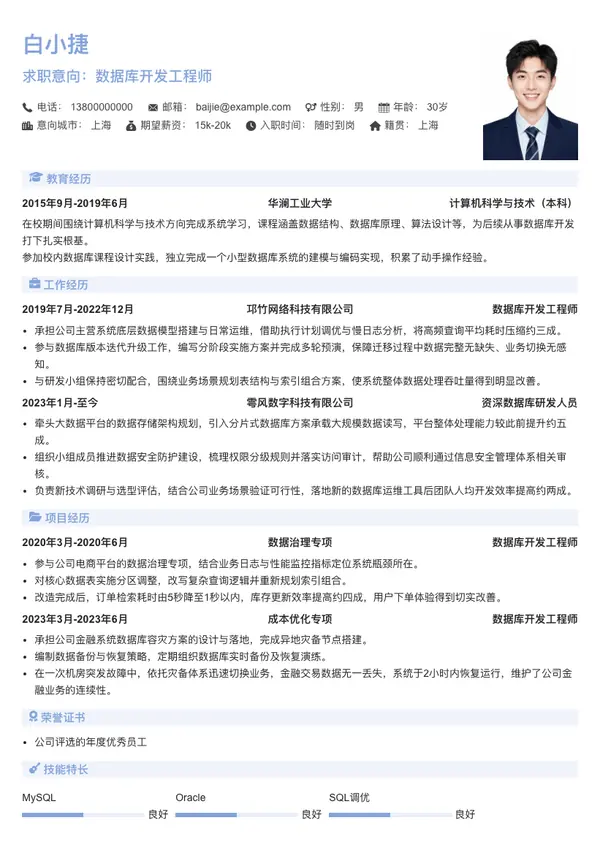
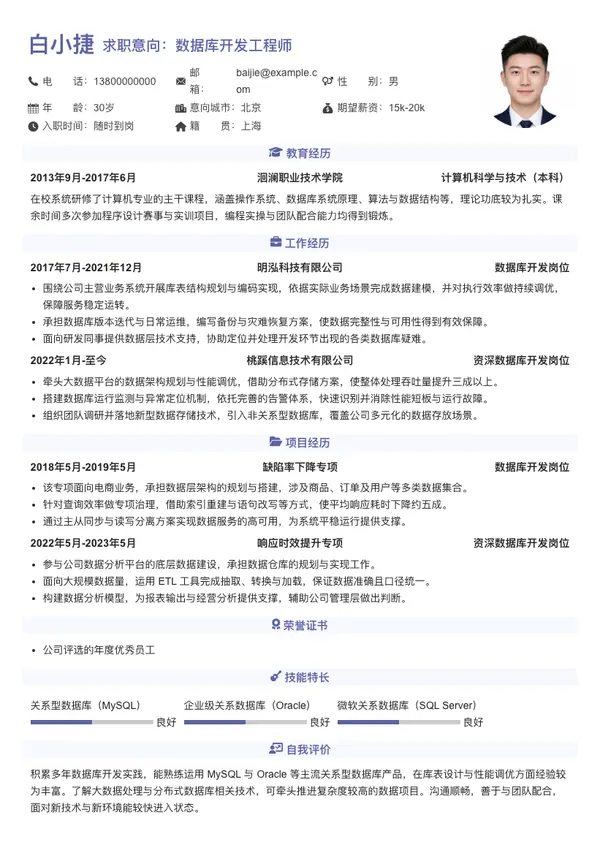
以下为根据本文案例生成的简历范文示例(姓名等均为示例信息)

白小捷
求职意向:数据库开发工程师
电话:18866666666
邮箱:baijie@example.com
意向城市:杭州

项目经历

2015年1月-至今
医疗术语标准化数据池建设
  • 此项目属于企业内部产品优化类工程。
  • 搭建标准化术语数据池的初衷,在于治理业务系统中医疗机构相关字段杂乱、口径不一的历史遗留问题。
  • 借助该术语池对散乱字段做统一映射,让后续数据统计与挖掘的准确程度得到明显改善。
  • 业务前端录入习惯差异大,加上存量记录体量庞大,系统在做聚合分析时经常出现结果偏差。基于此,项目确立的核心诉求是:统一医疗机构描述字段的写法,进而提升报表与模型的稳定性和可信度。
  • 主导术语池前期数据的抽取、转换与加载流程,并完成其在目标库中的结构落地。
  • 术语池投入运行后,长期困扰团队的字段口径混乱问题得到缓解,产品线的整体成熟度也随之提升。
2016年3月-至今
美业大数据分析平台 | 项目工具:Centos6.5、cloudera manage5.7、CDH5.7(hadoop2、sqoop、flume、kafka、zookeeper、hbase、hive、spark)、MySQL等
  • 大数据技术正在成为驱动企业增长的重要力量,未来数年内这一领域的竞争只会愈加激烈,机会与压力同时存在。
  • 在数据驱动的语境下,每一条记录都可能产生业务价值。
  • 数据来源之一:历史沉淀记录,时间跨度从1998年的线下台账一路延伸到当前实时写入的信息
  • 数据来源之二:移动客户端埋点日志,涵盖用户点击、浏览、停留等行为轨迹
  • 数据来源之三:对外采购与互换的补充数据,用于更细粒度地还原用户操作路径
  • 建设步骤划分为三段:先完成采集、清洗与计算框架的部署;
  • 再让数据湖完成入库并产出各产品的统计口径;
  • 最后对接外部数据源,落地分析模型、用户画像、推荐位与实时排行榜
  • 输出平台搭建的选型方案,并整理出可执行的分步实施文档
  • 将大体量存量记录按批次迁移入库
  • 对实时落地的日志做清洗与解析
  • 把实时日志同存量记录关联,生成较完整的用户行为画像
  • 依据业务口径编写并提交HQL脚本
2015年1月-至今
车企数据资产化分析平台 | 项目工具:linux、hadoop-2.6.0-cdh5.5.2、sqoop-1.4.6-cdh5.5.2、zookeeper-3.4.5-cdh5.5.2、hbase-1.0.0-cdh5.5.2、hive-1.1.0-cdh5.5.2、kafka、JDK 1.7.0、spark-1.5.0-cdh5.5.2、mysql、oracle等
  • 为顺应汽车产业的数字化趋势、盘活企业内部沉淀的数据资产,项目组引入云计算与大数据分析技术,搭建起一套面向业务决策的数据应用体系。
  • 数据输入端既涵盖企业内部的研发、制造、销售与售后等系统,也接入车联网、移动端等渠道,用于捕捉驾驶习惯、功能诉求以及用户不满等信息。
  • 上述数据经分析后形成结论,反哺车型研发方向调整与营销方案设计;
  • 支撑广告的定向触达;辅助产能与库存的动态调配;
  • 为销售跟进与售后响应提供数据依据和决策参考。
  • 通过统计用户审美倾向与驾驶习惯,为新车设计团队提供输入。
  • 当同一故障在特定车型上反复出现时,系统可经由车载终端或手机向车主推送提醒。
  • 引导车主预约到店做预防性检测,从而减少其等待时间。
  • 数据来源方面,厂商侧已沉淀了较完善的生产系统矩阵
  • 覆盖渠道端的经销商管理系统、客户关系管理平台、呼叫受理平台,
  • 以及制造执行与质量追溯类系统,基本能够支撑主机厂在经营、产品与渠道三个维度的日常分析。
  • 其一,车联网采集。已有相当比例的厂商完成或正在推进车联网部署,由此补足用户日常行车数据的空缺。
  • 以高级驾驶辅助模块为切口,可抓取每次出行的里程、变道偏好、时速区间以及疲劳驾驶判定等行为信号,
  • 同时回传转速、水温、电控参数等零部件运行指标,
  • 为质量趋势预判与精细化分析打下数据底子。
  • 其二,网络舆情采集。线上渠道早已超越传统触点,成为用户发声最集中、反馈最快的地方。
  • 团队自建分布式爬虫,或直接采购第三方舆情接口,
  • 围绕主流资讯门户、垂直行业站点、车主社区与电商评论区批量抓取新闻、帖文与评价文本,
  • 再借助大数据手段完成市场声量、品牌口碑、使用偏好与质量反馈等专题分析,例如按周输出品牌热度曲线与情感倾向分布。
  • 其三,外部合作数据。行业口径数据通过行业协会公开渠道引入,解决市场走势研判的样本问题;
  • 用户标签类数据则在与外部机构的数据互换中获得,因双方ID匹配命中率有限,必须先搭建统一的标签标准与多ID映射体系;
  • 更务实的路径是借外部资源先补全人群统计维度,再逐步完善画像细节。
  • 数据导入与预处理环节,通过sqoop把oracle端的记录抽取到hadoop集群,因上游涉及多套库、字段格式不统一,
  • 在入仓过程中同步做轻量清洗与条件过滤。
  • 数据分析与统计环节,按数据自身特征分门别类地汇总,覆盖大多数常规分析诉求。
  • 数据挖掘环节,在已汇总结果上叠加算法做更深层的模式识别。
  • 挖掘算法本身复杂度高、没有固定公式可套,这一环节最能体现团队的技术积淀,只有选对模型才能从海量记录中提炼出有价值的结论。
  • 项目架构按职能拆分为五个小组协同推进
  • 其一为采集组,借助自建爬虫从资讯站点与车主论坛批量拉取新闻正文、评论及帖文;
  • 其二为处理组,承接抽取链路的原始数据,完成去噪、条件过滤与小文件归并;
  • 其三为分析组,基于离线全量做多维汇总,输出各车型参数分布、返修频次排名及故障件编码清单;
  • 其四为算法组,负责建模选型与特征工程;
  • 其五为展示组,将结果落成可视化看板与区域投放建议。
  • 采集面覆盖资讯站点、论坛帖文与电商评价三类文本,从中提炼用户预期与集中反馈的车辆缺陷。
  • 行为侧则结合轨迹定位推断消费偏好,叠加驾驶习惯标签,为每位用户生成专属画像。
  • 同时按地域人群差异,分别配置差异化的广告投放策略。
  • 基于hadoop生态,用sqoop将oracle库的增量记录同步至HDFS
  • 在hive中完成数据加工,构建并迭代客户与车辆两类标签画像
  • 结合业务诉求对hive执行计划做性能优化
  • 根据业务口径编写HQL并持续调优
2015年8月-至今
寿险核心业务系统
  • 新核心业务系统通过承载前后台运营处理,覆盖保单从承保到终止的全流程环节,为外部差异化服务与内部集约运营提供底层支撑。
  • 为把个险理赔流程做得更系统、更智能、更集中,支撑业务扩张并形成理赔的全程可追踪,进而缩短处理时长、优化客户感受、增强客户留存,团队提出个险理赔新核心系统的建设诉求。
  • 新契约在保险公司运营链条中占据关键位置——一份生效保单正是从新契约环节起步,它是保险公司与客户确立合同关系的核心步骤。
  • 承保环节的模块可归为四大块:投保受理、核保管控、信息查询与统计报表。
  • 保全则指合同生效期间,为延续其效力,险企依约定及投保方、被保险方或受益方的申请所提供的一系列后续操作。
  • 这类操作通常涉及条款调整、年金派发或期满金支付等具体事项。
  • 维护库表与数据模型;定位并修复异常数据;
  • 编写数据迁移脚本并对其执行效率做优化
白小捷求职意向:数据库开发工程师
18866666666 · baijie@example.com

项目经历

医疗术语标准化数据池建设2015.01-至今
  • 此项目属于企业内部产品优化类工程。
  • 搭建标准化术语数据池的初衷,在于治理业务系统中医疗机构相关字段杂乱、口径不一的历史遗留问题。
  • 借助该术语池对散乱字段做统一映射,让后续数据统计与挖掘的准确程度得到明显改善。
  • 业务前端录入习惯差异大,加上存量记录体量庞大,系统在做聚合分析时经常出现结果偏差。基于此,项目确立的核心诉求是:统一医疗机构描述字段的写法,进而提升报表与模型的稳定性和可信度。
  • 主导术语池前期数据的抽取、转换与加载流程,并完成其在目标库中的结构落地。
  • 术语池投入运行后,长期困扰团队的字段口径混乱问题得到缓解,产品线的整体成熟度也随之提升。
美业大数据分析平台 | 项目工具:Centos6.5、cloudera manage5.7、CDH5.7(hadoop2、sqoop、flume、kafka、zookeeper、hbase、hive、spark)、MySQL等2016.03-至今
  • 大数据技术正在成为驱动企业增长的重要力量,未来数年内这一领域的竞争只会愈加激烈,机会与压力同时存在。
  • 在数据驱动的语境下,每一条记录都可能产生业务价值。
  • 数据来源之一:历史沉淀记录,时间跨度从1998年的线下台账一路延伸到当前实时写入的信息
  • 数据来源之二:移动客户端埋点日志,涵盖用户点击、浏览、停留等行为轨迹
  • 数据来源之三:对外采购与互换的补充数据,用于更细粒度地还原用户操作路径
  • 建设步骤划分为三段:先完成采集、清洗与计算框架的部署;
  • 再让数据湖完成入库并产出各产品的统计口径;
  • 最后对接外部数据源,落地分析模型、用户画像、推荐位与实时排行榜
  • 输出平台搭建的选型方案,并整理出可执行的分步实施文档
  • 将大体量存量记录按批次迁移入库
  • 对实时落地的日志做清洗与解析
  • 把实时日志同存量记录关联,生成较完整的用户行为画像
  • 依据业务口径编写并提交HQL脚本
车企数据资产化分析平台 | 项目工具:linux、hadoop-2.6.0-cdh5.5.2、sqoop-1.4.6-cdh5.5.2、zookeeper-3.4.5-cdh5.5.2、hbase-1.0.0-cdh5.5.2、hive-1.1.0-cdh5.5.2、kafka、JDK 1.7.0、spark-1.5.0-cdh5.5.2、mysql、oracle等2015.01-至今
  • 为顺应汽车产业的数字化趋势、盘活企业内部沉淀的数据资产,项目组引入云计算与大数据分析技术,搭建起一套面向业务决策的数据应用体系。
  • 数据输入端既涵盖企业内部的研发、制造、销售与售后等系统,也接入车联网、移动端等渠道,用于捕捉驾驶习惯、功能诉求以及用户不满等信息。
  • 上述数据经分析后形成结论,反哺车型研发方向调整与营销方案设计;
  • 支撑广告的定向触达;辅助产能与库存的动态调配;
  • 为销售跟进与售后响应提供数据依据和决策参考。
  • 通过统计用户审美倾向与驾驶习惯,为新车设计团队提供输入。
  • 当同一故障在特定车型上反复出现时,系统可经由车载终端或手机向车主推送提醒。
  • 引导车主预约到店做预防性检测,从而减少其等待时间。
  • 数据来源方面,厂商侧已沉淀了较完善的生产系统矩阵
  • 覆盖渠道端的经销商管理系统、客户关系管理平台、呼叫受理平台,
  • 以及制造执行与质量追溯类系统,基本能够支撑主机厂在经营、产品与渠道三个维度的日常分析。
  • 其一,车联网采集。已有相当比例的厂商完成或正在推进车联网部署,由此补足用户日常行车数据的空缺。
  • 以高级驾驶辅助模块为切口,可抓取每次出行的里程、变道偏好、时速区间以及疲劳驾驶判定等行为信号,
  • 同时回传转速、水温、电控参数等零部件运行指标,
  • 为质量趋势预判与精细化分析打下数据底子。
  • 其二,网络舆情采集。线上渠道早已超越传统触点,成为用户发声最集中、反馈最快的地方。
  • 团队自建分布式爬虫,或直接采购第三方舆情接口,
  • 围绕主流资讯门户、垂直行业站点、车主社区与电商评论区批量抓取新闻、帖文与评价文本,
  • 再借助大数据手段完成市场声量、品牌口碑、使用偏好与质量反馈等专题分析,例如按周输出品牌热度曲线与情感倾向分布。
  • 其三,外部合作数据。行业口径数据通过行业协会公开渠道引入,解决市场走势研判的样本问题;
  • 用户标签类数据则在与外部机构的数据互换中获得,因双方ID匹配命中率有限,必须先搭建统一的标签标准与多ID映射体系;
  • 更务实的路径是借外部资源先补全人群统计维度,再逐步完善画像细节。
  • 数据导入与预处理环节,通过sqoop把oracle端的记录抽取到hadoop集群,因上游涉及多套库、字段格式不统一,
  • 在入仓过程中同步做轻量清洗与条件过滤。
  • 数据分析与统计环节,按数据自身特征分门别类地汇总,覆盖大多数常规分析诉求。
  • 数据挖掘环节,在已汇总结果上叠加算法做更深层的模式识别。
  • 挖掘算法本身复杂度高、没有固定公式可套,这一环节最能体现团队的技术积淀,只有选对模型才能从海量记录中提炼出有价值的结论。
  • 项目架构按职能拆分为五个小组协同推进
  • 其一为采集组,借助自建爬虫从资讯站点与车主论坛批量拉取新闻正文、评论及帖文;
  • 其二为处理组,承接抽取链路的原始数据,完成去噪、条件过滤与小文件归并;
  • 其三为分析组,基于离线全量做多维汇总,输出各车型参数分布、返修频次排名及故障件编码清单;
  • 其四为算法组,负责建模选型与特征工程;
  • 其五为展示组,将结果落成可视化看板与区域投放建议。
  • 采集面覆盖资讯站点、论坛帖文与电商评价三类文本,从中提炼用户预期与集中反馈的车辆缺陷。
  • 行为侧则结合轨迹定位推断消费偏好,叠加驾驶习惯标签,为每位用户生成专属画像。
  • 同时按地域人群差异,分别配置差异化的广告投放策略。
  • 基于hadoop生态,用sqoop将oracle库的增量记录同步至HDFS
  • 在hive中完成数据加工,构建并迭代客户与车辆两类标签画像
  • 结合业务诉求对hive执行计划做性能优化
  • 根据业务口径编写HQL并持续调优
寿险核心业务系统2015.08-至今
  • 新核心业务系统通过承载前后台运营处理,覆盖保单从承保到终止的全流程环节,为外部差异化服务与内部集约运营提供底层支撑。
  • 为把个险理赔流程做得更系统、更智能、更集中,支撑业务扩张并形成理赔的全程可追踪,进而缩短处理时长、优化客户感受、增强客户留存,团队提出个险理赔新核心系统的建设诉求。
  • 新契约在保险公司运营链条中占据关键位置——一份生效保单正是从新契约环节起步,它是保险公司与客户确立合同关系的核心步骤。
  • 承保环节的模块可归为四大块:投保受理、核保管控、信息查询与统计报表。
  • 保全则指合同生效期间,为延续其效力,险企依约定及投保方、被保险方或受益方的申请所提供的一系列后续操作。
  • 这类操作通常涉及条款调整、年金派发或期满金支付等具体事项。
  • 维护库表与数据模型;定位并修复异常数据;
  • 编写数据迁移脚本并对其执行效率做优化

以上姓名、联系方式等均为示例信息。

以上范文可供借鉴,挑出你最具代表性的项目,把个人贡献用数据讲清楚,实力自然不言自明。

✓写作要点

  • 把你在项目里实际动手做的事和团队的整体产出分开写,让面试官一眼看出哪部分是你独立完成的。
  • 工具链和技术方案要落到具体名称和版本上,比如用了哪种抽取工具、哪套调度框架,这样才和数据库开发岗位的硬技能对得上。
  • 按背景—任务—动作—结果四段来组织,每一段都给出可验证的细节,而不是笼统地说参与了某项目。

✕常见误区

  • 通篇只堆项目名称和工具清单,读者翻完仍不知道你具体承担了哪块工作。
  • 效果描述停留在定性层面,缺少数字或可对比的指标来佐证产出。

★加分技巧

  • 技术类项目写清楚你负责的那一层架构和对应模块,比笼统罗列整条技术栈更能显出专业纵深。
  • 把项目中踩过的坑和最后的解决路径写出来,能反映你的排查思路和判断力。

看完范文,照着做一份自己的简历

数据库开发工程师的模板已备好,填好信息即可导出 PDF / Word,免费使用。
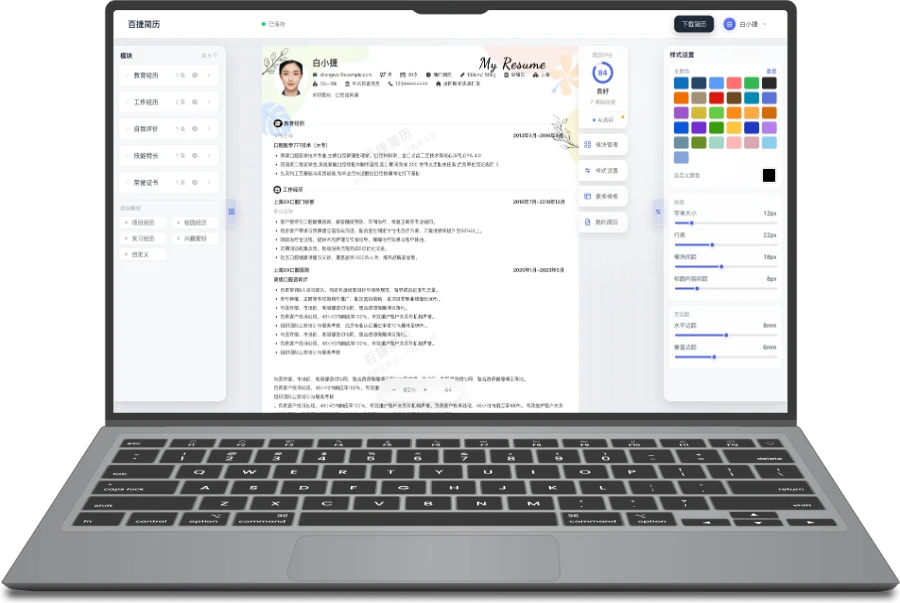
简历编辑器界面预览

立即创建您的专属简历

免费制作 · 海量模板 · 一键下载

开始制作