百捷简历

大数据开发工程师简历工作经历怎么写

不少大数据开发方向的求职者在简历上容易写偏,其实只要把握住“贴合岗位”和“用数据说话”这两条主线,效果就会明显不同。下面这份范文可供对照参考。

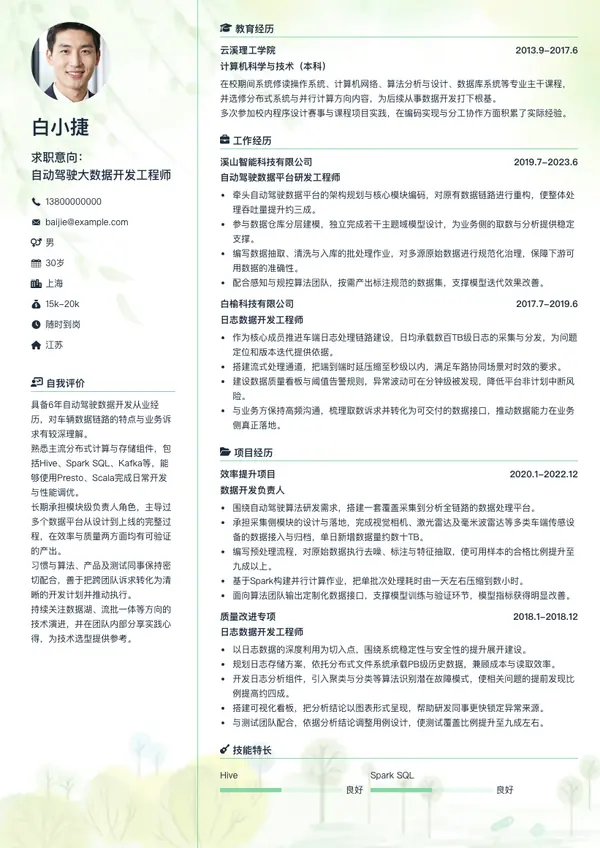
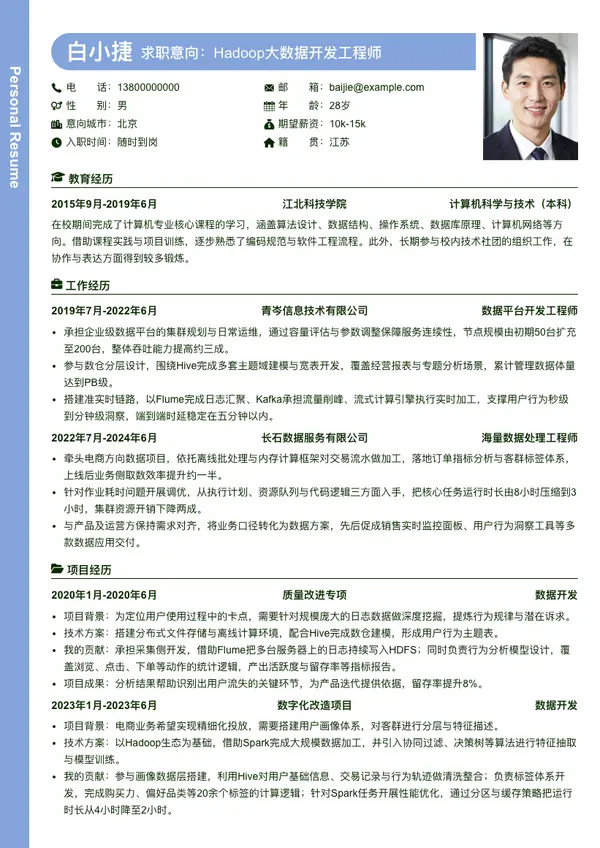
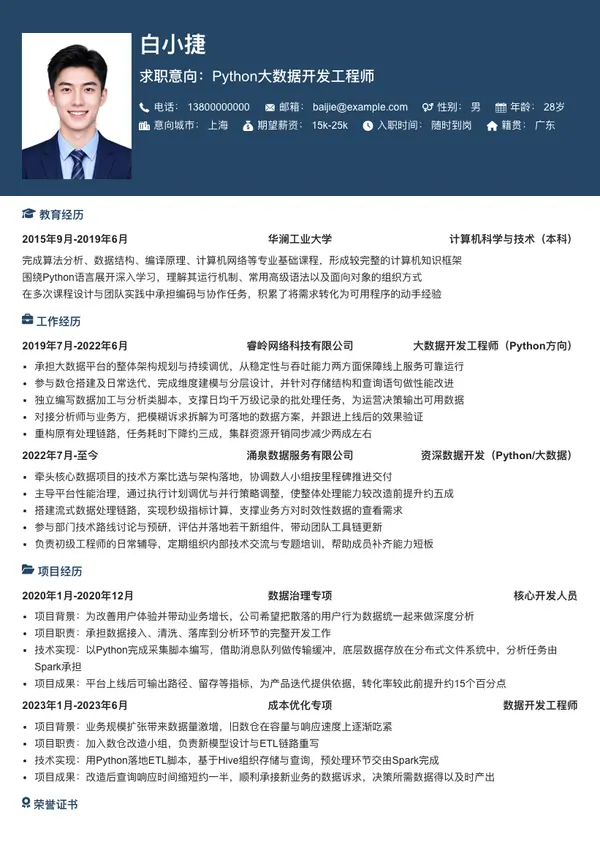
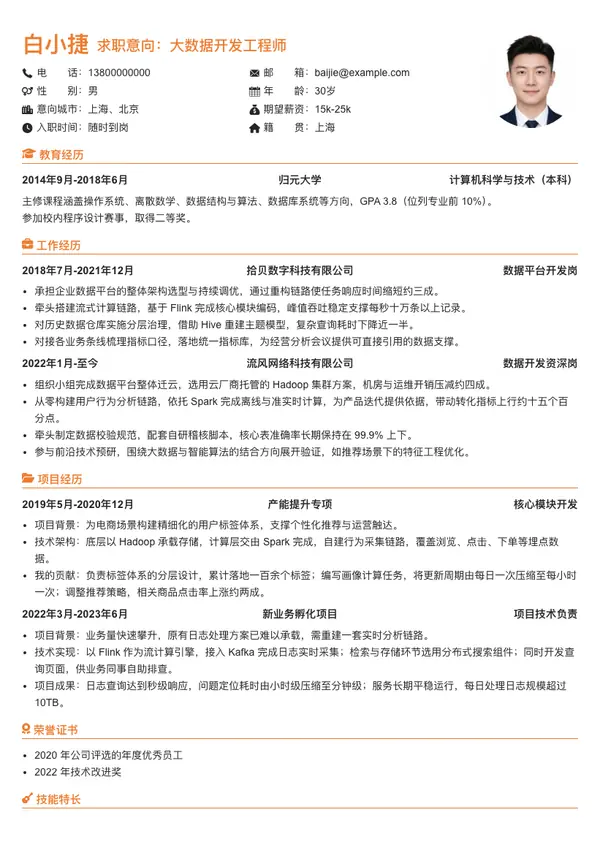
以下为根据本文案例生成的简历范文示例(姓名等均为示例信息)

RESUME
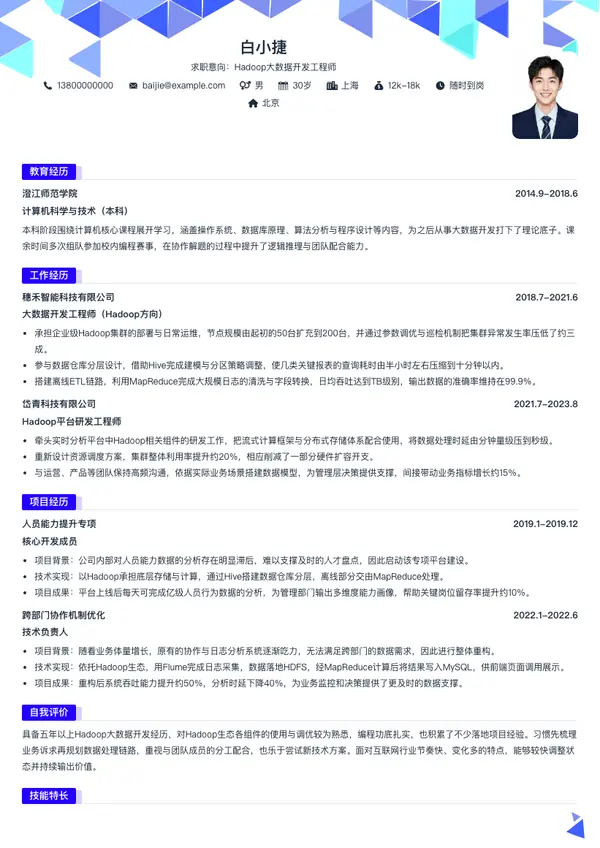
白小捷
求职意向:大数据开发工程师找工作
电话:18866666666
邮箱:baijie@example.com
意向城市:杭州

工作经历

2015年7月-2016年2月
觞咏科技股份有限公司
风险控制
  • 采集授信对象的多维度信息,套用适配的评分逻辑完成风险定级,并输出分层结果供业务参照。
  • 伴随算法升级与合规要求变动,主导识别模型的重构:向研发侧同步需求并跟踪上线,联合市场团队制定落地方案,协同视觉设计完成前端页面的迭代改版。
2015年9月-至今
穆清科技有限公司 - 数据部
大数据开发工程师
  • 主导数据底座的组件选型、环境部署及参数调优工作。
  • 结合业务目标,对终端埋点及社交渠道数据展开多视角拆解,提炼用户行为画像与产品运营关键指标。
  • 将清洗后的结果集同步至关系型数据库并开放接口,为产品团队及管理层在广告策略创新、转化效果提升等场景提供数据支撑。
  • 运用SparkSQL对用户行为明细进行高效清洗与聚合运算。
  • 承担集群与作业的例行巡检、异常定位及性能优化。

自我评价

对编程抱有持续热情,长期关注IT技术领域的发展动态

在团队协作中能主动沟通、有效配合,推动问题快速解决

做事有担当,对交付结果负责到底

教育经历

2011年9月-2015年7月
黍谷文理学院
计算机科学与技术(本科)
  • 计算机科学与技术本科,系统学习数据结构、数据库原理与分布式计算等课程,毕业设计聚焦大数据处理方向。

项目经历

2016年1月-至今
网络内容识别与规则自动迭代平台
  • 该平台以运营商侧用户访问日志为输入源,整合地址过滤、规则匹配、爬虫采集、内容还原及文本挖掘等多项技术,
  • 构建可配置的可视化操作界面,并实现识别规则的自动更新,同时打通采集技术与报文深度还原能力,串联标签规则的全周期管理,
  • 对移动端用户的访问轨迹、浏览内容及应用使用情况实施精细识别,精准响应客户数据与业务数据的分析需要,
  • 辅以数据整合、建模、挖掘与清洗等步骤,形成针对垂直领域的大数据洞察与分析能力。
  • 平台由以下模块构成
  • 地址分类模块,接收抽样后的上网记录,依据应用、栏目、搜索、元数据及噪音等规则集完成清洗,产出样本供规则分析岗使用。
  • 采集地址生成模块,可读取全量上网记录,结合应用、元数据及噪音等规则集自动推导出待抓取链接,供采集调度调用。
  • 重点应用地址提取模块,针对全量上网记录,运用应用、栏目、搜索、元数据及噪音等规则集筛选出重点应用数据,交付规则分析人员。
  • 采集执行模块,读取待抓取链接列表,抓取目标页面并生成链接索引文件与页面内容文件,供页面处理模块调用。
  • 页面解析模块,读取索引与内容文件,依照页面规则集产出内容元数据,写入对应应用的元数据库。
  • 规则管理模块,提供内容规则库的可视化操作界面。
  • 参与系统架构及库表结构设计,重点承担页面内容分析模块与采集地址生成模块的开发。
  • 页面内容分析模块:通过配置内容提取规则,将抓取内容与内容元数据关联,构建内容元数据规则库;
  • 可支撑网页及应用更新状态判定、编码识别、标题提取与正文内容获取等能力。
  • 采集地址生成模块:以应用栏目动作规则库、内容规则库、内容元数据规则库和噪音库为基础,对传入的完整上网记录做规则解析并还原出可抓取地址,供采集端消费。
2008年9月-至今
医疗结算后台数据服务
  • 面向参保人员住院收费场景的业务系统,覆盖门诊、药店管理、住院管理、报表统计、信息维护、查询检索及权限配置等模块。
  • 前期参与详细设计与编码实现,承担住院费用核销与药店账务清算的底层算法开发,使用PLSQL编写Oracle存储过程,完成医疗数据的转换与迁移,并负责数据库表维护及SQL调优。

技能特长

掌握数据建模的基本理论与常见方法
精通
理解Flume、Logstash的采集机
熟练
熟悉Kafka的运行机制,可独立完成集群
良好
能熟练运用Sqoop在关系型数据库与Hd
精通
对Azkaban任务调度系统有一定了解
良好
熟练编写Spark RDD、Spark
精通
掌握Hbase的工作机制,可独立搭建Hb
良好
能熟练使用Hive完成数据查询分析及ET
精通
熟悉HDFS存储、MapReduce离线
精通
熟练使用Scala、Java进行开发,能
精通
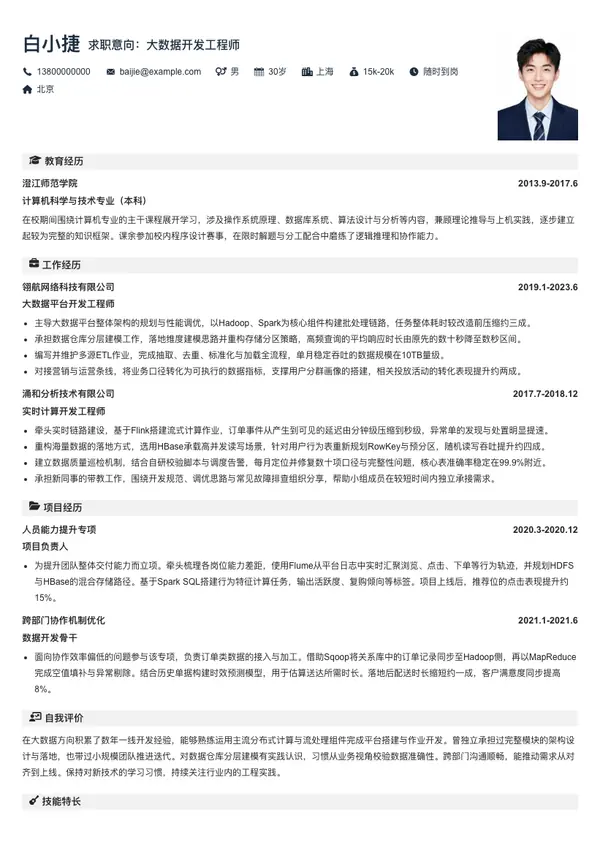
白小捷求职意向:大数据开发工程师找工作
18866666666 · baijie@example.com

工作经历

觞咏科技股份有限公司 · 风险控制2015.07-2016.02
  • 采集授信对象的多维度信息,套用适配的评分逻辑完成风险定级,并输出分层结果供业务参照。
  • 伴随算法升级与合规要求变动,主导识别模型的重构:向研发侧同步需求并跟踪上线,联合市场团队制定落地方案,协同视觉设计完成前端页面的迭代改版。
穆清科技有限公司 - 数据部 · 大数据开发工程师2015.09-至今
  • 主导数据底座的组件选型、环境部署及参数调优工作。
  • 结合业务目标,对终端埋点及社交渠道数据展开多视角拆解,提炼用户行为画像与产品运营关键指标。
  • 将清洗后的结果集同步至关系型数据库并开放接口,为产品团队及管理层在广告策略创新、转化效果提升等场景提供数据支撑。
  • 运用SparkSQL对用户行为明细进行高效清洗与聚合运算。
  • 承担集群与作业的例行巡检、异常定位及性能优化。

自我评价

对编程抱有持续热情,长期关注IT技术领域的发展动态

在团队协作中能主动沟通、有效配合,推动问题快速解决

做事有担当,对交付结果负责到底

教育经历

黍谷文理学院 · 计算机科学与技术2011.09-2015.07
  • 计算机科学与技术本科,系统学习数据结构、数据库原理与分布式计算等课程,毕业设计聚焦大数据处理方向。

项目经历

网络内容识别与规则自动迭代平台2016.01-至今
  • 该平台以运营商侧用户访问日志为输入源,整合地址过滤、规则匹配、爬虫采集、内容还原及文本挖掘等多项技术,
  • 构建可配置的可视化操作界面,并实现识别规则的自动更新,同时打通采集技术与报文深度还原能力,串联标签规则的全周期管理,
  • 对移动端用户的访问轨迹、浏览内容及应用使用情况实施精细识别,精准响应客户数据与业务数据的分析需要,
  • 辅以数据整合、建模、挖掘与清洗等步骤,形成针对垂直领域的大数据洞察与分析能力。
  • 平台由以下模块构成
  • 地址分类模块,接收抽样后的上网记录,依据应用、栏目、搜索、元数据及噪音等规则集完成清洗,产出样本供规则分析岗使用。
  • 采集地址生成模块,可读取全量上网记录,结合应用、元数据及噪音等规则集自动推导出待抓取链接,供采集调度调用。
  • 重点应用地址提取模块,针对全量上网记录,运用应用、栏目、搜索、元数据及噪音等规则集筛选出重点应用数据,交付规则分析人员。
  • 采集执行模块,读取待抓取链接列表,抓取目标页面并生成链接索引文件与页面内容文件,供页面处理模块调用。
  • 页面解析模块,读取索引与内容文件,依照页面规则集产出内容元数据,写入对应应用的元数据库。
  • 规则管理模块,提供内容规则库的可视化操作界面。
  • 参与系统架构及库表结构设计,重点承担页面内容分析模块与采集地址生成模块的开发。
  • 页面内容分析模块:通过配置内容提取规则,将抓取内容与内容元数据关联,构建内容元数据规则库;
  • 可支撑网页及应用更新状态判定、编码识别、标题提取与正文内容获取等能力。
  • 采集地址生成模块:以应用栏目动作规则库、内容规则库、内容元数据规则库和噪音库为基础,对传入的完整上网记录做规则解析并还原出可抓取地址,供采集端消费。
医疗结算后台数据服务2008.09-至今
  • 面向参保人员住院收费场景的业务系统,覆盖门诊、药店管理、住院管理、报表统计、信息维护、查询检索及权限配置等模块。
  • 前期参与详细设计与编码实现,承担住院费用核销与药店账务清算的底层算法开发,使用PLSQL编写Oracle存储过程,完成医疗数据的转换与迁移,并负责数据库表维护及SQL调优。

技能特长

掌握数据建模的基本理论与常见方法理解Flume、Logstash的采集机熟悉Kafka的运行机制,可独立完成集群能熟练运用Sqoop在关系型数据库与Hd对Azkaban任务调度系统有一定了解熟练编写Spark RDD、Spark 掌握Hbase的工作机制,可独立搭建Hb能熟练使用Hive完成数据查询分析及ET熟悉HDFS存储、MapReduce离线熟练使用Scala、Java进行开发,能

以上姓名、联系方式等均为示例信息。

把简历逐条对照目标岗位的要求去打磨,让最相关的能力和成果被看见,面试机会自然会多起来。

✓写作要点

  • 把岗位JD中出现的技术栈和业务关键词自然嵌入经历描述,让筛选系统第一时间识别到匹配度。
  • 成果尽量给数字:集群规模、日处理量、查询耗时下降比例、任务稳定率,这些比形容词更有说服力。
  • 围绕目标岗位重组内容,与大数据开发无关的校园活动或短期兼职可以压缩甚至删去。

✕常见误区

  • 把项目背景写成了产品说明书,篇幅很长却看不出个人做了什么。
  • 格式随意、中英文标点混用,甚至出现错别字,会让面试官质疑你的严谨度。
  • 拿同一份简历投递所有公司,完全不考虑岗位方向差异,比如偏实时计算和偏数仓的岗位要求并不相同。

★加分技巧

  • 用短标题分段并保留适当行距,让招聘方扫一眼就能定位到技术栈和项目角色。
  • 投递前先拆解目标岗位的职责描述,把其中出现的技术名词逐一对应到自己的项目经历里。
  • 排序遵循匹配度优先:与岗位最贴近的项目写在最前面,篇幅也分配得最多。

看完范文,照着做一份自己的简历

大数据开发工程师找工作的模板已备好,填好信息即可导出 PDF / Word,免费使用。
简历编辑器界面预览

立即创建您的专属简历

免费制作 · 海量模板 · 一键下载

开始制作