百捷简历

大数据工程师完整简历范文

大数据工程师的简历常犯一个毛病:技术词堆了一堆,却看不出你到底解决了什么问题。把「岗位匹配度」和「成果可量化」这两条抓住,简历的说服力会明显不一样。下面这份范文可以对照着改。

以下为根据本文案例生成的简历范文示例(姓名等均为示例信息)

RESUME
白小捷
求职意向:大数据工程师完整
电话:18866666666
邮箱:baijie@example.com
意向城市:杭州

项目经历

2016年9月-2017年9月
周期压缩专项
  • 项目名称:准实时用户行为洞察系统
  • 技术架构:分布式存储与批流计算组合方案,覆盖数据采集、消息队列、离线运算、流式处理、元数据管理与关系型存储等组件
  • 开发环境:主流Linux发行版与Windows双平台,搭配集成开发工具、项目构建工具、Web容器、Java运行时及集中式版本控制
  • 项目描述:面向公司内部产品与运营团队,搭建可按需筛选用户群体、查看流量走向的交互式分析工具。
  • 使用方在界面中选定分析场景后,进入任务配置页填写过滤条件与运行参数并提交。
  • 系统依据任务类别匹配对应的批处理作业,另起子线程以命令提交方式触发执行。
  • 计算环节依托资源调度集群完成,借助结构化查询引擎对分布式文件系统中的大体量数据完成运算,结果回写至原存储。
  • 同时接入日志采集、消息中间件与内存计算引擎,通过流式计算通道支撑流式场景的即时分析。
  • 分析产出经由界面渲染后供使用方查阅,为其优化产品策略或调整运营动作提供依据。
  • 项目职责:承担集群的搭建与部署,参与需求梳理、库表结构设计,并完成编码、测试与调优工作。
  • 开发步骤:采集侧由日志采集组件对接供应商接口抓取数据,通过自定义拦截器适配业务规则;
  • 消息队列承接采集端的数据并转交流式计算引擎完成实时抽取转换加载,处理结果落盘至分布式文件系统。
  • 处理侧由批处理内核读取分布式文件系统数据,分别以弹性数据集做离线运算、以离散化数据流做准实时运算,产出仍存回原存储。
  • 展示侧借助数据库连接读取加工后的数据,驱动图表完成可视化呈现。
  • 功能模块:访问会话切分统计、页面流失比例测算、各区域热销品类排行、广告点击流量即时监控
2014年11月-2017年9月
响应时效提升专项
  • 与芯片厂商内部团队协作,为数据中心平台新版本上线提供性能评估与调优支持
  • 选取TPCx-BB、TPC-DS等大数据基准,对新平台的基础性能表现进行摸底评测。
  • 从Hadoop、Java、操作系统、BIOS等多个层面入手实施调优,把软硬件资源的潜力尽量释放出来。
  • 整理技术分析文档并提交至数据中心部门,配合完成评审流转。

工作经历

2010年3月-2014年5月
昭苏数据服务有限公司 - 软件与服务事业集团/数据解决方案事业部
高级软件测试工程师
  • 梳理测试范围并拆解需求点,据此编排测试排期、协调人力与设备投入;
  • 独立完成用例编写,并搭建自动化测试脚本与配套辅助工具,减少重复执行成本;
  • 主导功能、性能及长稳三类集成验证,输出缺陷记录并跟进修复,最终交付系统测试与验收文档;
  • 与研发侧协同定位性能短板,围绕资源占用、响应耗时等维度给出可落地的改进方案;
  • 梳理质量保障链路中的冗余环节,推动流程精简,提升验证工作的可复用性。
2015年11月-2017年9月
秋屿有限公司
大数据工程师
  • 依据业务诉求完成大数据侧功能模块的架构设计与落地实现;
  • 投身数据洞察、模型抽象及功能规划等环节,支撑数据类产品的迭代研发;
  • 探索脏数据识别与异常值修补的多种技术路径,沉淀可复用的处理规则;
  • 跟进主流数据分析方法论,评估其在现有业务场景中的适用性;
  • 承担数据洞察类产品的方案设计与编码实现,保障交付质量。

自我评价

对Hadoop生态中的Flume、Sqoop、Zookeeper等开源组件较为熟悉,掌握Java与Linux,能用MySQL、Oracle处理关系型数据,具备Hive数仓使用经验与SQL编写能力,理解Yarn调度机制和MapReduce运行原理,对HBase、Spark及Spark RDD有一定了解

为人随和且注重细节,交付前习惯反复核对,能承受高强度节奏,做事讲求落地,对结果负责;既能融入协作,也能独立推进任务,思路较为灵活。

教育经历

2011年9月-2015年7月
筠州文理学院
计算机科学与技术(本科)
  • 主修计算机科学与技术,系统学习数据结构、数据库与分布式计算等课程,具备扎实的编程与系统开发能力。

技能特长

可独立完成Hadoop2.x集群的安装与
良好
熟悉MySQL与ORACLE的安装配置,
良好
白小捷求职意向:大数据工程师完整
18866666666 · baijie@example.com

项目经历

周期压缩专项2016.09-2017.09
  • 项目名称:准实时用户行为洞察系统
  • 技术架构:分布式存储与批流计算组合方案,覆盖数据采集、消息队列、离线运算、流式处理、元数据管理与关系型存储等组件
  • 开发环境:主流Linux发行版与Windows双平台,搭配集成开发工具、项目构建工具、Web容器、Java运行时及集中式版本控制
  • 项目描述:面向公司内部产品与运营团队,搭建可按需筛选用户群体、查看流量走向的交互式分析工具。
  • 使用方在界面中选定分析场景后,进入任务配置页填写过滤条件与运行参数并提交。
  • 系统依据任务类别匹配对应的批处理作业,另起子线程以命令提交方式触发执行。
  • 计算环节依托资源调度集群完成,借助结构化查询引擎对分布式文件系统中的大体量数据完成运算,结果回写至原存储。
  • 同时接入日志采集、消息中间件与内存计算引擎,通过流式计算通道支撑流式场景的即时分析。
  • 分析产出经由界面渲染后供使用方查阅,为其优化产品策略或调整运营动作提供依据。
  • 项目职责:承担集群的搭建与部署,参与需求梳理、库表结构设计,并完成编码、测试与调优工作。
  • 开发步骤:采集侧由日志采集组件对接供应商接口抓取数据,通过自定义拦截器适配业务规则;
  • 消息队列承接采集端的数据并转交流式计算引擎完成实时抽取转换加载,处理结果落盘至分布式文件系统。
  • 处理侧由批处理内核读取分布式文件系统数据,分别以弹性数据集做离线运算、以离散化数据流做准实时运算,产出仍存回原存储。
  • 展示侧借助数据库连接读取加工后的数据,驱动图表完成可视化呈现。
  • 功能模块:访问会话切分统计、页面流失比例测算、各区域热销品类排行、广告点击流量即时监控
响应时效提升专项2014.11-2017.09
  • 与芯片厂商内部团队协作,为数据中心平台新版本上线提供性能评估与调优支持
  • 选取TPCx-BB、TPC-DS等大数据基准,对新平台的基础性能表现进行摸底评测。
  • 从Hadoop、Java、操作系统、BIOS等多个层面入手实施调优,把软硬件资源的潜力尽量释放出来。
  • 整理技术分析文档并提交至数据中心部门,配合完成评审流转。

工作经历

昭苏数据服务有限公司 - 软件与服务事业集团/数据解决方案事业部 · 高级软件测试工程师2010.03-2014.05
  • 梳理测试范围并拆解需求点,据此编排测试排期、协调人力与设备投入;
  • 独立完成用例编写,并搭建自动化测试脚本与配套辅助工具,减少重复执行成本;
  • 主导功能、性能及长稳三类集成验证,输出缺陷记录并跟进修复,最终交付系统测试与验收文档;
  • 与研发侧协同定位性能短板,围绕资源占用、响应耗时等维度给出可落地的改进方案;
  • 梳理质量保障链路中的冗余环节,推动流程精简,提升验证工作的可复用性。
秋屿有限公司 · 大数据工程师2015.11-2017.09
  • 依据业务诉求完成大数据侧功能模块的架构设计与落地实现;
  • 投身数据洞察、模型抽象及功能规划等环节,支撑数据类产品的迭代研发;
  • 探索脏数据识别与异常值修补的多种技术路径,沉淀可复用的处理规则;
  • 跟进主流数据分析方法论,评估其在现有业务场景中的适用性;
  • 承担数据洞察类产品的方案设计与编码实现,保障交付质量。

自我评价

对Hadoop生态中的Flume、Sqoop、Zookeeper等开源组件较为熟悉,掌握Java与Linux,能用MySQL、Oracle处理关系型数据,具备Hive数仓使用经验与SQL编写能力,理解Yarn调度机制和MapReduce运行原理,对HBase、Spark及Spark RDD有一定了解

为人随和且注重细节,交付前习惯反复核对,能承受高强度节奏,做事讲求落地,对结果负责;既能融入协作,也能独立推进任务,思路较为灵活。

教育经历

筠州文理学院 · 计算机科学与技术2011.09-2015.07
  • 主修计算机科学与技术,系统学习数据结构、数据库与分布式计算等课程,具备扎实的编程与系统开发能力。

技能特长

可独立完成Hadoop2.x集群的安装与熟悉MySQL与ORACLE的安装配置,

以上姓名、联系方式等均为示例信息。

把目标岗位的要求拆成条目,逐项在你的简历里找到对应证据,让每一段经历都能回答「这跟岗位有什么关系」。做到这一点,面试邀约率自然会往上走。

✓写作要点

  • 篇幅控制在一页以内为宜,有多年经验者可放宽到两页,版式上保持留白,用加粗把面试官最该看到的数字拎出来。
  • 技术栈、工具名、业务场景这些关键词要自然嵌入职责描述里,让筛选系统能命中大数据工程师的岗位画像。
  • 每条经历配一到两个可核验的数字,比如处理的数据量级、优化的耗时比例、支撑的团队规模,比空写「大幅提升」有说服力。

✕常见误区

  • 拿同一份简历海投所有JD,岗位方向差异大时命中率会明显下滑。
  • 通篇罗列做了什么,却看不到做到了什么程度,招聘方无法判断你的水平区间。
  • 把项目介绍整段搬进简历,信息密度过低,关键成果反而被淹没。

★加分技巧

  • 动笔之前先拆解目标岗位的JD,把对方列出的技术点与你的经历逐一挂钩,缺哪块就补哪块的描述。
  • 能用数据说明的地方不要用形容词,把「提升效率」换成具体的百分比或时长,可信度会高一个档次。

看完范文,照着做一份自己的简历

大数据工程师完整的模板已备好,填好信息即可导出 PDF / Word,免费使用。
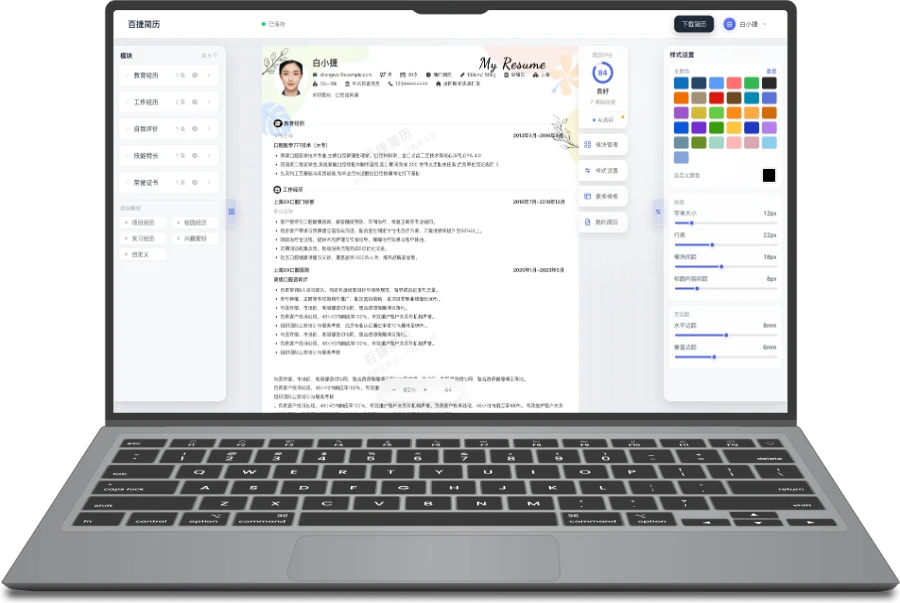
简历编辑器界面预览

立即创建您的专属简历

免费制作 · 海量模板 · 一键下载

开始制作