百捷简历

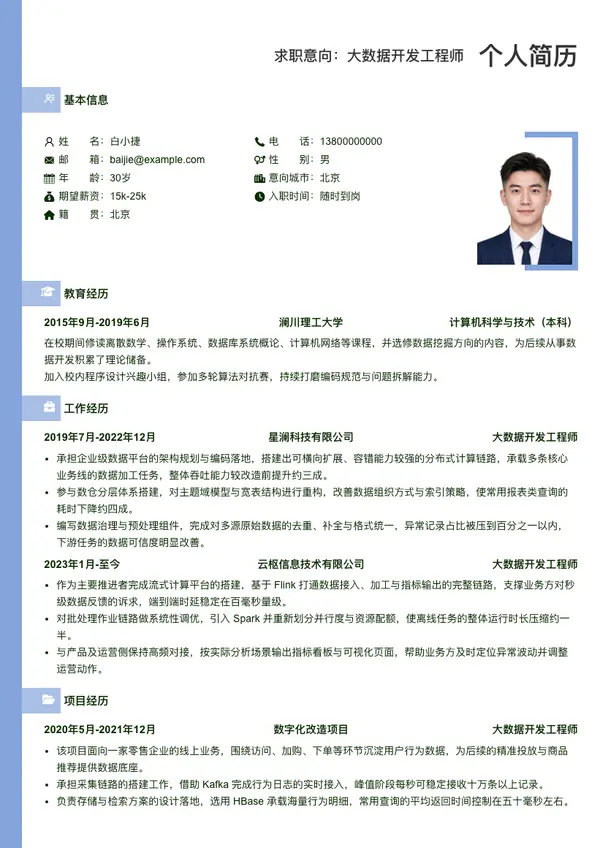
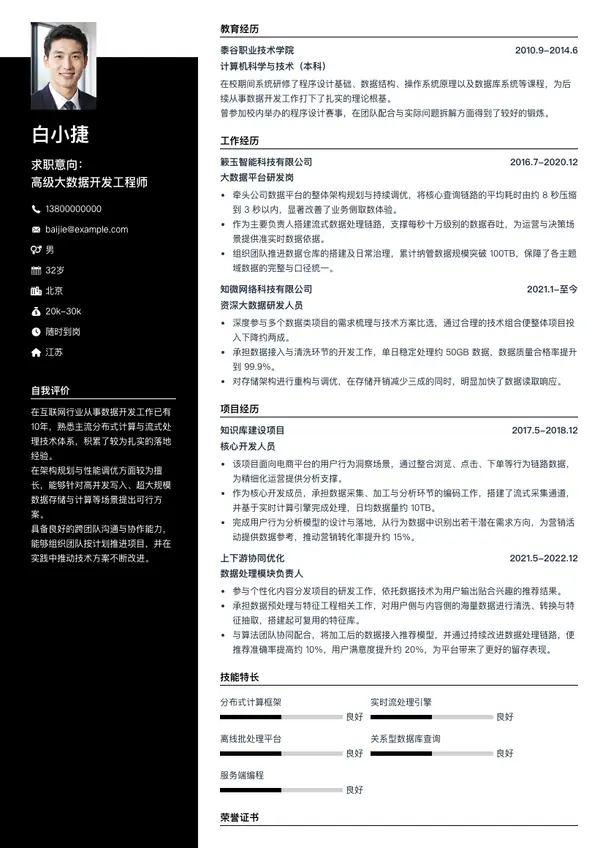
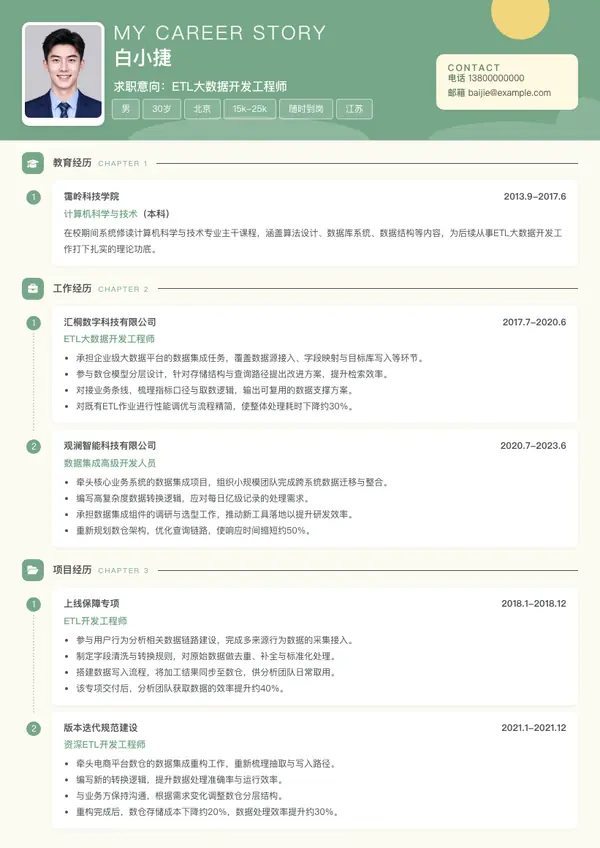
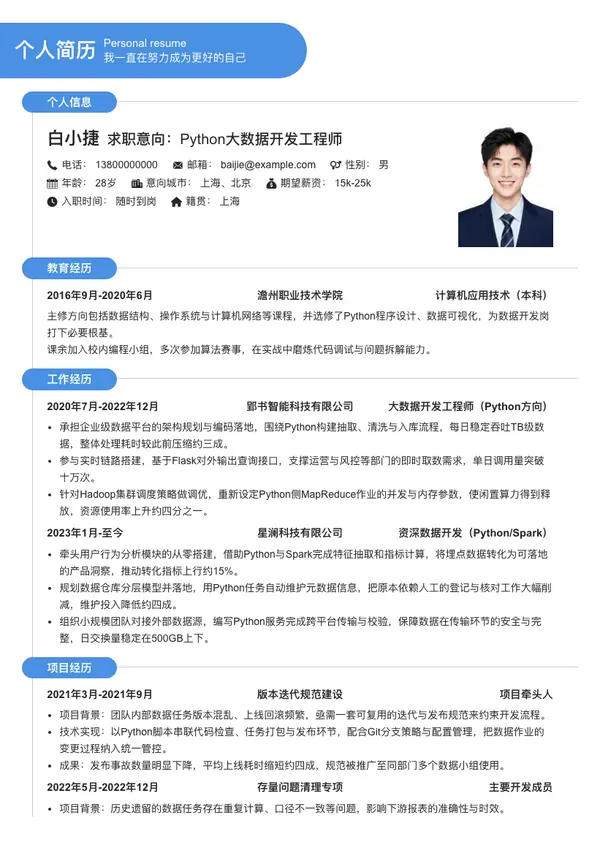
以下为根据本文案例生成的简历范文示例(姓名等均为示例信息)

RESUME
白小捷
求职意向:大数据开发工程师
电话:18866666666
邮箱:baijie@example.com
意向城市:杭州

项目经历

2014年6月-2014年12月
审计作业流程管理工具
  • 该产品参考海外同类工具的架构思路,在设计中引入辩证分析逻辑,成为国内较早落地的自研成果,获得行业协会及多家会计师事务所的认可,也是当时市场上少数能与主流商业审计软件形成竞争关系的产品之一。核心界面围绕审计流程框架搭建,覆盖作业步骤、问题应答、关键操作、审计程序与底稿列示等环节。
  • 功能菜单涵盖:项目档案维护(新建、移除、变更、备份、还原)、参数配置、移动端拍照取证、财务数据模块(导入、初始化、维护、总账及核算明细账预览)、审计调整模块(负值重分类、期初与期末账表调整、期初与期末审计调整、分录导入导出)、底稿模块(信息维护、签名、导入导出、归档)以及在线帮助等。
  • 在Windows 7环境下基于VS2008与MySQL数据库,采用MFC框架完成客户端功能开发。
2016年4月-2016年12月
保险集团数据中台构建
  • 该项目把来自多个业务系统的数据汇聚后统一加工,再输出给集团内各业务平台使用。数据先经sqoop一类ETL组件从增量库生成Gz压缩包,由调度平台送入Hbase;随后用oozie串联Mapreduce、Spark批处理、HiveSQL及sqoop等任务周期性运转,加工产物落在Hbase表或Hive内部表;最后开放WebService对外接口,以ImpalaSQL将数据供给各子系统消费。
  • 承担指定业务域内Mapreduce程序的编码实现。
  • 针对Mapreduce执行效率与HbaseAPI调用接口进行优化。
  • 处理平台日常运行中的异常问题,并提升调度平台任务执行效率。
  • 基于Spark完成离线场景下业务指标的逻辑计算。
  • 使用Spark-Streaming消费kafka流式数据,加工后回写至hbase。
2016年6月-2017年5月
游戏业务日志分析平台
  • 公司旗下运营多款游戏产品,每日产生的数据分散在不同物理机上,给统一管理带来很大难度。为兼顾存储效率、安全性与完整性,需要搭建统一的大数据平台集中承载这些数据。同时还要对每日新增数据做统计分析,涉及DAU、DNU、留存率、流失情况、付费偏好及渠道异常排查等维度。此外,集群硬件配置需要随业务需求灵活调整。综合以上因素,团队选定Hadoop体系作为底层架构。
  • 采集到的数据分为两类:一类是事件型信息,记录某用户在某时刻完成登录或发生购买等行为,这类数据在系统中占比最高且持续快速增长;另一类是用户属性信息,例如某用户首次充值的具体日期等。
  • 整体处理路径为:由hadoop集群以分布式方式承接logstash采集的玩家行为记录,先经mapreduce过滤清洗后落地到HDFS,再借助hive与spark展开分析,从数据走势中判断游戏当下运营健康度,最终把统计结果一并写入mysql与redis集中管控。
  • 使用logstash从日志服务器和缓存数据库中抽取日志文件与数据,写入HDFS。
  • 编写mapreduce任务完成数据清洗,提取有效字段。
  • 将清洗结果导入hive做进一步分析,并通过sqoop把统计结果导出至mysql保存。
  • 借助spark对事件类日志做统计计算,经jdbc将结果写入mysql。
  • 使用HBase存储加工后的数据。
  • 对mapreduce与hive执行调优,编写并优化HQL语句。
  • 负责日常数据的管理与维护工作。
2015年12月-2016年6月
电商用户行为洞察
  • 该项目面向电商平台用户行为分析场景,目标是通过Logstash采集海量购物浏览与消费数据,经由kafka中转后进入Spark完成分析处理。统计指标包括页面跳转率、每日成交笔数、用户来源访问排名、每日新增用户规模、每日热销商品前十、实时成交金额以及实时黑名单等。分析结果以图表形式呈现,为业务决策提供数据支撑,帮助运营团队直观掌握平台运行状态,并依据用户行为特征及时调整营销方案,从而提升活跃用户规模,推动平台持续增长。
  • 完成Hadoop、Spark、Hive与Zookeeper集群的部署搭建。
  • 执行数据清洗与基础预处理。
  • 承担离线侧指标(来源渠道访问排序、新增用户规模、页面跳出比例、热销单品前十)及实时侧指标(成交金额、黑名单)的计算任务。
  • 优化HQL语句执行效率。
白小捷求职意向:大数据开发工程师
18866666666 · baijie@example.com

项目经历

审计作业流程管理工具2014.06-2014.12
  • 该产品参考海外同类工具的架构思路,在设计中引入辩证分析逻辑,成为国内较早落地的自研成果,获得行业协会及多家会计师事务所的认可,也是当时市场上少数能与主流商业审计软件形成竞争关系的产品之一。核心界面围绕审计流程框架搭建,覆盖作业步骤、问题应答、关键操作、审计程序与底稿列示等环节。
  • 功能菜单涵盖:项目档案维护(新建、移除、变更、备份、还原)、参数配置、移动端拍照取证、财务数据模块(导入、初始化、维护、总账及核算明细账预览)、审计调整模块(负值重分类、期初与期末账表调整、期初与期末审计调整、分录导入导出)、底稿模块(信息维护、签名、导入导出、归档)以及在线帮助等。
  • 在Windows 7环境下基于VS2008与MySQL数据库,采用MFC框架完成客户端功能开发。
保险集团数据中台构建2016.04-2016.12
  • 该项目把来自多个业务系统的数据汇聚后统一加工,再输出给集团内各业务平台使用。数据先经sqoop一类ETL组件从增量库生成Gz压缩包,由调度平台送入Hbase;随后用oozie串联Mapreduce、Spark批处理、HiveSQL及sqoop等任务周期性运转,加工产物落在Hbase表或Hive内部表;最后开放WebService对外接口,以ImpalaSQL将数据供给各子系统消费。
  • 承担指定业务域内Mapreduce程序的编码实现。
  • 针对Mapreduce执行效率与HbaseAPI调用接口进行优化。
  • 处理平台日常运行中的异常问题,并提升调度平台任务执行效率。
  • 基于Spark完成离线场景下业务指标的逻辑计算。
  • 使用Spark-Streaming消费kafka流式数据,加工后回写至hbase。
游戏业务日志分析平台2016.06-2017.05
  • 公司旗下运营多款游戏产品,每日产生的数据分散在不同物理机上,给统一管理带来很大难度。为兼顾存储效率、安全性与完整性,需要搭建统一的大数据平台集中承载这些数据。同时还要对每日新增数据做统计分析,涉及DAU、DNU、留存率、流失情况、付费偏好及渠道异常排查等维度。此外,集群硬件配置需要随业务需求灵活调整。综合以上因素,团队选定Hadoop体系作为底层架构。
  • 采集到的数据分为两类:一类是事件型信息,记录某用户在某时刻完成登录或发生购买等行为,这类数据在系统中占比最高且持续快速增长;另一类是用户属性信息,例如某用户首次充值的具体日期等。
  • 整体处理路径为:由hadoop集群以分布式方式承接logstash采集的玩家行为记录,先经mapreduce过滤清洗后落地到HDFS,再借助hive与spark展开分析,从数据走势中判断游戏当下运营健康度,最终把统计结果一并写入mysql与redis集中管控。
  • 使用logstash从日志服务器和缓存数据库中抽取日志文件与数据,写入HDFS。
  • 编写mapreduce任务完成数据清洗,提取有效字段。
  • 将清洗结果导入hive做进一步分析,并通过sqoop把统计结果导出至mysql保存。
  • 借助spark对事件类日志做统计计算,经jdbc将结果写入mysql。
  • 使用HBase存储加工后的数据。
  • 对mapreduce与hive执行调优,编写并优化HQL语句。
  • 负责日常数据的管理与维护工作。
电商用户行为洞察2015.12-2016.06
  • 该项目面向电商平台用户行为分析场景,目标是通过Logstash采集海量购物浏览与消费数据,经由kafka中转后进入Spark完成分析处理。统计指标包括页面跳转率、每日成交笔数、用户来源访问排名、每日新增用户规模、每日热销商品前十、实时成交金额以及实时黑名单等。分析结果以图表形式呈现,为业务决策提供数据支撑,帮助运营团队直观掌握平台运行状态,并依据用户行为特征及时调整营销方案,从而提升活跃用户规模,推动平台持续增长。
  • 完成Hadoop、Spark、Hive与Zookeeper集群的部署搭建。
  • 执行数据清洗与基础预处理。
  • 承担离线侧指标(来源渠道访问排序、新增用户规模、页面跳出比例、热销单品前十)及实时侧指标(成交金额、黑名单)的计算任务。
  • 优化HQL语句执行效率。

以上姓名、联系方式等均为示例信息。

对照上面几份大数据开发工程师的项目经验写法,挑出最能代表你能力的项目,把个人贡献用数据说清楚,实力自然就立住了。

✓写作要点

  • 精选2~4个能体现技术深度的项目来写,把篇幅留给最有说服力的那个。
  • 把成果落到可验证的数字上——上线周期、性能提升幅度、成本节省比例、用户增长规模都比形容词管用。
  • 按背景、职责、动作、结果的顺序组织每个项目,让面试官能快速判断你的实际贡献。

✕常见误区

  • 项目堆得太多反而稀释了重点,招聘方很难从中抓取关键信息。
  • 光列项目名不交代自己做了什么,读起来像团队履历而非个人简历。

★加分技巧

  • 缺少正式项目时,课程设计、自研作品或开源社区的贡献同样可以写进简历。
  • 技术项目要把用到的技术栈和自己负责的具体模块对应起来写,这样才看得出专业深度。

看完范文,照着做一份自己的简历

大数据开发工程师的模板已备好,填好信息即可导出 PDF / Word,免费使用。
简历编辑器界面预览

立即创建您的专属简历

免费制作 · 海量模板 · 一键下载

开始制作