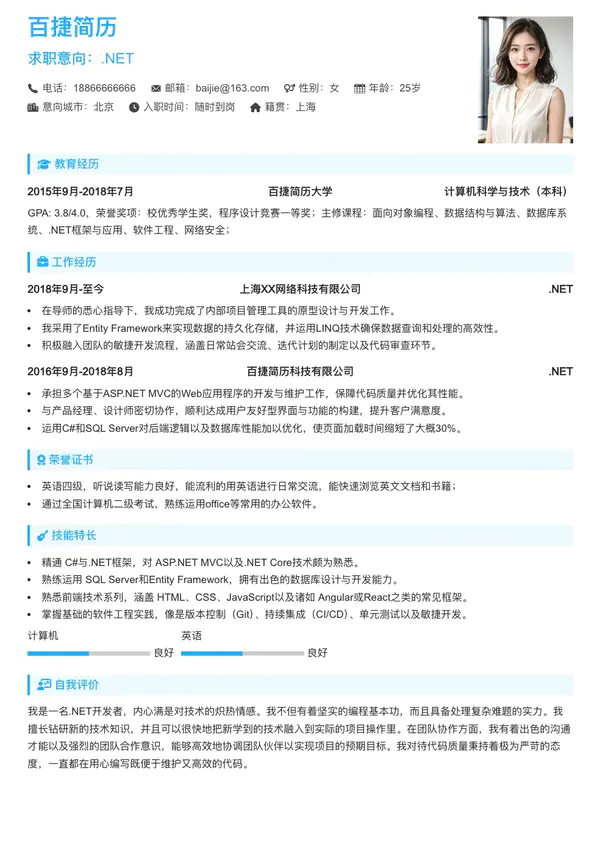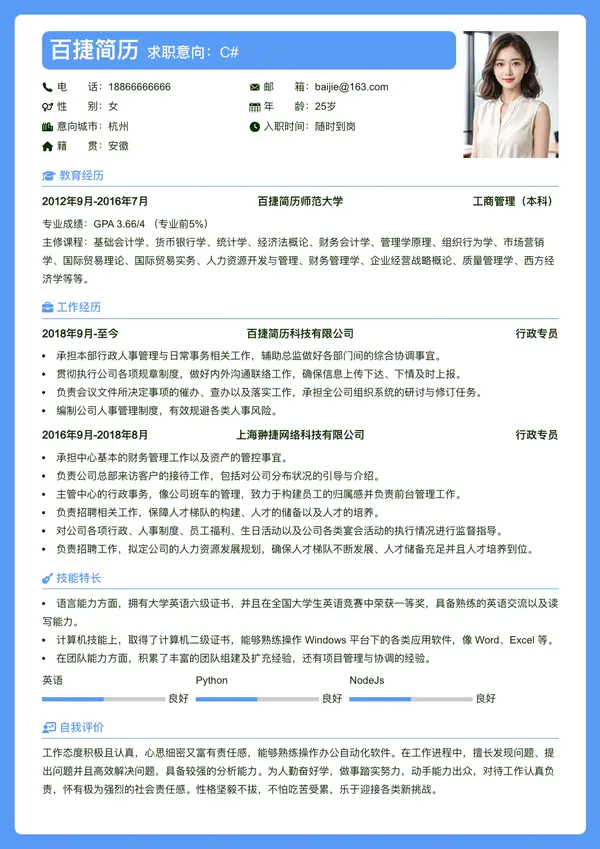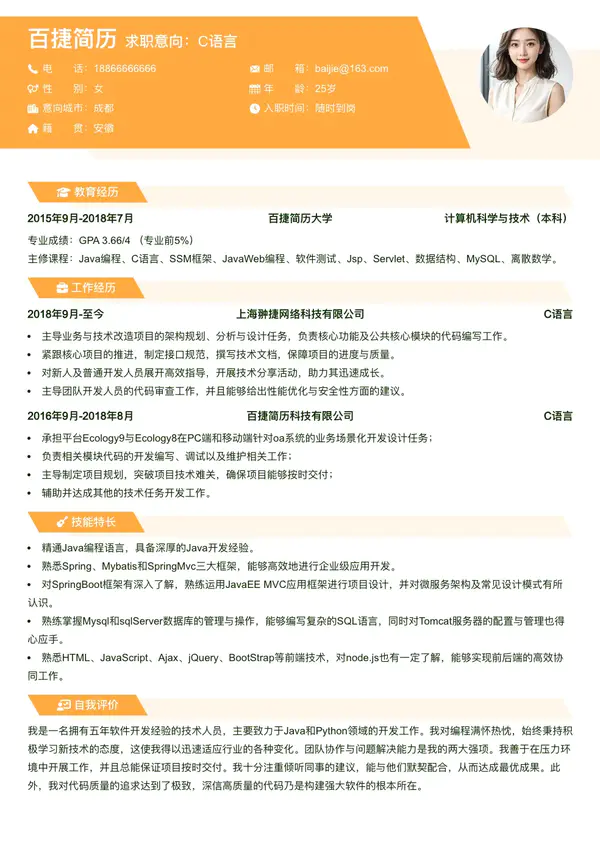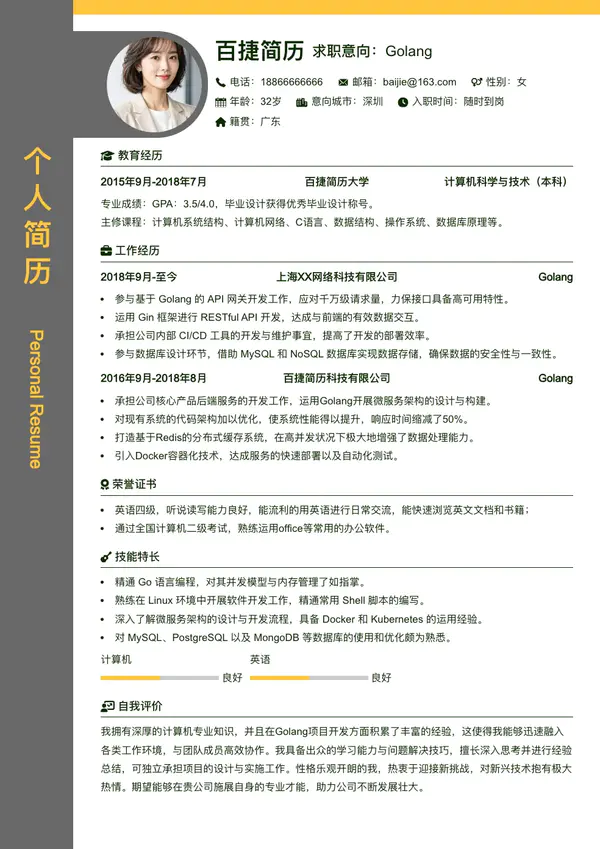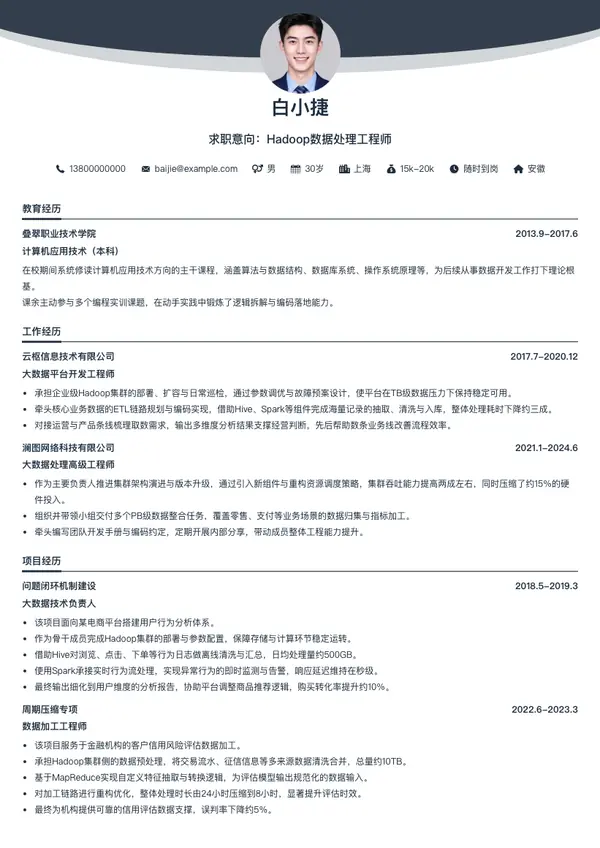
百捷简历提供Hadoop数据处理工程师简历模板,板块与配色均可自定义,内置 AI 润色、技能条与荣誉展示墙,版式一键可换。配合 AI 优化简历表述,几分钟做好完整范本,让求职和谈薪都更有把握。
白小捷
求职意向:Hadoop数据处理工程师
13800000000
baijie@example.com
男
30岁
上海
15k-20k
随时到岗
安徽
教育经历
2013.9-2017.6
叠翠职业技术学院
计算机应用技术(本科)
在校期间系统修读计算机应用技术方向的主干课程,涵盖算法与数据结构、数据库系统、操作系统原理等,为后续从事数据开发工作打下理论根基。
课余主动参与多个编程实训课题,在动手实践中锻炼了逻辑拆解与编码落地能力。
工作经历
2017.7-2020.12
云枢信息技术有限公司
大数据平台开发工程师
- 承担企业级Hadoop集群的部署、扩容与日常巡检,通过参数调优与故障预案设计,使平台在TB级数据压力下保持稳定可用。
- 牵头核心业务数据的ETL链路规划与编码实现,借助Hive、Spark等组件完成海量记录的抽取、清洗与入库,整体处理耗时下降约三成。
- 对接运营与产品条线梳理取数需求,输出多维度分析结果支撑经营判断,先后帮助数条业务线改善流程效率。
2021.1-2024.6
澜图网络科技有限公司
大数据处理高级工程师
- 作为主要负责人推进集群架构演进与版本升级,通过引入新组件与重构资源调度策略,集群吞吐能力提高两成左右,同时压缩了约15%的硬件投入。
- 组织并带领小组交付多个PB级数据整合任务,覆盖零售、支付等业务场景的数据归集与指标加工。
- 牵头编写团队开发手册与编码约定,定期开展内部分享,带动成员整体工程能力提升。
项目经历
2018.5-2019.3
问题闭环机制建设
大数据技术负责人
- 该项目面向某电商平台搭建用户行为分析体系。
- 作为骨干成员完成Hadoop集群的部署与参数配置,保障存储与计算环节稳定运转。
- 借助Hive对浏览、点击、下单等行为日志做离线清洗与汇总,日均处理量约500GB。
- 使用Spark承接实时行为流处理,实现异常行为的即时监测与告警,响应延迟维持在秒级。
- 最终输出细化到用户维度的分析报告,协助平台调整商品推荐逻辑,购买转化率提升约10%。
2022.6-2023.3
周期压缩专项
数据加工工程师
- 该项目服务于金融机构的客户信用风险评估数据加工。
- 承担Hadoop集群侧的数据预处理,将交易流水、征信信息等多来源数据清洗合并,总量约10TB。
- 基于MapReduce实现自定义特征抽取与转换逻辑,为评估模型输出规范化的数据输入。
- 对加工链路进行重构优化,整体处理时长由24小时压缩到8小时,显著提升评估时效。
- 最终为机构提供可靠的信用评估数据支撑,误判率下降约5%。
自我评价
积累多年大数据加工方向的实战经验,对分布式存储、批处理计算、数仓查询与内存计算等主流技术路线的适用场景及调优方式较为熟悉,技术基础扎实。
在数据链路设计与性能优化方面有较深积累,能够从容应对大规模数据的加工需求,并具备多个完整项目的落地经历。
善于与跨职能团队配合沟通,可带队推进复杂数据项目;同时保持对新技术的关注,学习意愿与改进意识较强。
技能特长
Hadoop生态组件
良好
Hive/Spark SQL
良好
脚本化数据处理
良好
数据链路架构设计
良好
荣誉证书
- 获评公司年度优秀技师
Hadoop数据处理工程师简历模板
自定义板块自定义颜色AI润色AI点评一键更换模板
百捷简历提供Hadoop数据处理工程师简历模板,板块与配色均可自定义,内置 AI 润色、技能条与荣誉展示墙,版式一键可换。配合 AI 优化简历表述,几分钟做好完整范本,让求职和谈薪都更有把握。
使用此模板- 云端操作,实时保存
- 排版格式完整,导出不乱版
- 打印效果最好
- 操作简单、制作快速